「達人に学ぶDB設計徹底指南書」を読んで学んだこと
はじめまして!システム開発部2年目社員のカンダです(^^)/
今回は「達人に学ぶDB設計徹底指南書 第2版」を読んだ感想と、特に学びになったポイントをまとめてみました!
なぜこの本を手に取ったのか?
実務では、仕様書を読み込みながらテーブルやAPIの設計を考えることがあります。
そんなとき、私の頭にはこのような疑問が浮かんでくるのです……
- 「そもそも、何の値をテーブルに保存すればいいんだ?」
- 「このカラムは既存のテーブルに入れていい?それとも別テーブルに分けるべき?」
- 「ユーザーID以外に、どこにインデックスを貼ればいいんだ?」
実際の設計では、既存のテーブルを参考にしたりAIや先輩に質問することで、
このような疑問を解消しつつ設計を進めています。
そのように繰り返し設計をするうちに、
「今回の仕様なら、こんなテーブル構成になりそうだな」
「このカラムは別テーブルに分けたほうが使いやすそうだな」
と、なんとなく良さそうな形を想像できるようになってきました。
こんな感じで、経験を積むことにより前よりはスムーズに設計できるようになってきたのですが、
あるときよく考えてみると、既存のテーブルの形にならって作っているだけで、
「そもそも、なぜこのテーブル構造が良いのか?」という根本を理解した上で設計できていないことに気づきました。
そこで、良いDB設計とは何なのか、その判断基準を学び根拠と自信を持ってDB設計ができるようになりたい!と思い、
この本を手に取りました。
実際に読んでみて、私と同じような悩みを抱える1〜2年目のエンジニアに、とてもおすすめできるなと感じました!
達人に学ぶDB設計徹底指南書 第2版には以下の内容が盛り込まれています。
知りたいことが書いてありそうだなと思いましたらぜひ読んでみてください!
【目次】
第1章 データベースを制する者はシステムを制す
第2章 論理設計と物理設計
第3章 論理設計と正規化~なぜテーブルは分割する必要があるのか?
第4章 ER図~複数のテーブルの関係を表現する
第5章 論理設計とパフォーマンス~正規化の欠点と非正規化
第6章 データベースとパフォーマンス
第7章 論理設計のアンチパターン
第8章 論理設計のグレーノウハウ
第9章 一歩進んだ論理設計~RDBで木構造を扱う
付録(演習問題の回答)
全体的な感想
- 文章が平易で分かりやすく、挫折しない・飽きない作りになっている
癖のある表現や引っかかる文章がなく、とても読みやすかったです。
個人的には、本にコードがたくさん出てくると「私には読むのが100万年早かったか…」と挫折しがちなのですが、
DBの話ということもあり、SQL文がちょろっと出てくる程度なので、抵抗感なく読み進めることができました。
また、文章中には定期的に「勘どころ」として重要なポイントが簡潔にまとめられていたり、演習問題が用意されていたりします。
そのため、挫折することも飽きることもなく読み進められました! - DB設計をするときに、いろんな視点を持てるようになる
この本はあくまでも「指南書」なので、特定の領域について深く掘り下げていたり
具体的なDB設計の手順が詳しく書かれていたりするわけではありません。
しかし、そもそも「データベースとは何なのか?」というところから、
実務でも役に立ちそうな正規化とパフォーマンスのトレードオフの話まで、幅広くカバーされています。
読む難易度としても、難しすぎず、易しすぎずという印象でした。
実務でも触れることの多い正規化やER図についても書かれているので、
実務経験がある方なら概念が分からなくて読み進められないことは無いと思います。
一方で、後半に向けては徐々に理論寄りの内容になっていきます。
第9章の「一歩進んだ論理設計~RDBで木構造を扱う」などは、実務ですぐに使うというよりも
DBについてさらに深く知りたい人向けの内容だと感じました。
そのため、まずは実務に直接関係しそうな箇所を読んでみて、理論寄りの部分は時間があるときに読む、といった読み方がおすすめです!
特に学びになったこと
なぜDB設計を最初にやるのか?
「なぜDB設計を最初にやるんだろう?」と考えたことはありますか?
私はDB設計を最初にやることが当たり前だと思いすぎて、疑ったことすらありませんでした。
しかしこの本を読んで、プログラムより先にデータを設計するというのは昔から当たり前だったわけではなく、
かつては逆の順番でやっていた時代もあったことを知りました。
「データ ⇒ プログラム」の順に設計する考え方をデータ中心アプローチ(DOA)、
「プログラム ⇒ データ」の順に設計する考え方をプロセス中心アプローチ(POA)といいます。
POAからDOAへと主流が移っていった背景が気になったので、少し調べてみました。
POAが主流だった時代
POAは1960〜70年代頃のシステム開発で主流だった考え方のひとつです。
当時は「給与計算をコンピューターでやろう!」といったように、
人間がアナログで行っていた作業をコンピューターに置き換えていく流れがありました。
そうなると、まずは人間が具体的にどんな作業をしていたかを洗い出し、
それをそのままプログラムにしていくことになります。
給与計算を例に作業を洗い出すと、以下のようになります。
- タイムカードを集める
- 出勤日数と残業時間を数える
- 社員名簿から基本給を調べる
- 残業代を足し、税金や保険料を引いて支給額を出す
あとは、この手順をそのままプログラムにしていきます。
どんなデータをどう保管するかは、その手順が固まってからプログラムの都合に合わせて決めます。
手順が先でデータは後という進め方がPOAです。
DOAが重視されるようになった理由
しかし、業務処理というのは変わるものです。
たとえば「社員の基本給」というデータは、給与計算でも人事評価でも使われます。
ところがプロセス中心で設計すると、給与計算用のデータ、人事評価用のデータ……と、プロセスごとにデータを持つことになります。中身は同じ「社員の基本給」なのに、同じ情報があちこちに散らばってしまうわけです。
こうなると、基本給が改定されたときに、すべての場所を漏れなく直さなければいけません。
ひとつ更新し忘れれば、画面によって違う金額が出てしまいます。
そこで重視されるようになったのがDOAでした。
プロセスはいくらでも変化する一方で、最終的に扱うデータそのものは、プロセスに比べて変化しにくいです(永続的である)。この点に着目して、データの意味や形式を先に決めようというのがDOAの考え方です。
先に「社員という情報は、社員番号・氏名・所属・基本給を持つ」と決めておけば、給与計算だろうと人事評価だろうと、どのプロセスからも同じデータを参照するだけで済みます。基本給が改定されても、直す場所はひとつです。
さらに、リレーショナルデータベースの普及も後押しになりました。ファイルにデータを置いていた時代と違い、データを一元管理して、あとから自由に組み合わせて取り出せるようになったからです。データを中心に据える設計が、技術的にも現実的になったわけですね。
こうして、今の「まずDB設計から」という当たり前ができあがっていきました。
では、そのDB設計とは具体的に何を決める作業なのか。
ユーザーごとに、必要なデータだけを切り取って見せる層です。
たとえば、社員情報を扱うシステムなら、社員一覧画面では氏名や所属だけを表示し
別の画面では給与まで表示するといったように、同じデータを用途に応じて違う形で見せることができます。
見た目は違っても、裏側にあるデータはもちろん共通です。
同じデータを、見る人や用途によって違う形に切り取る。 この見せ方の定義が外部スキーマにあたります。
それを知るには、3層スキーマという概念を押さえる必要があります。
3層スキーマ
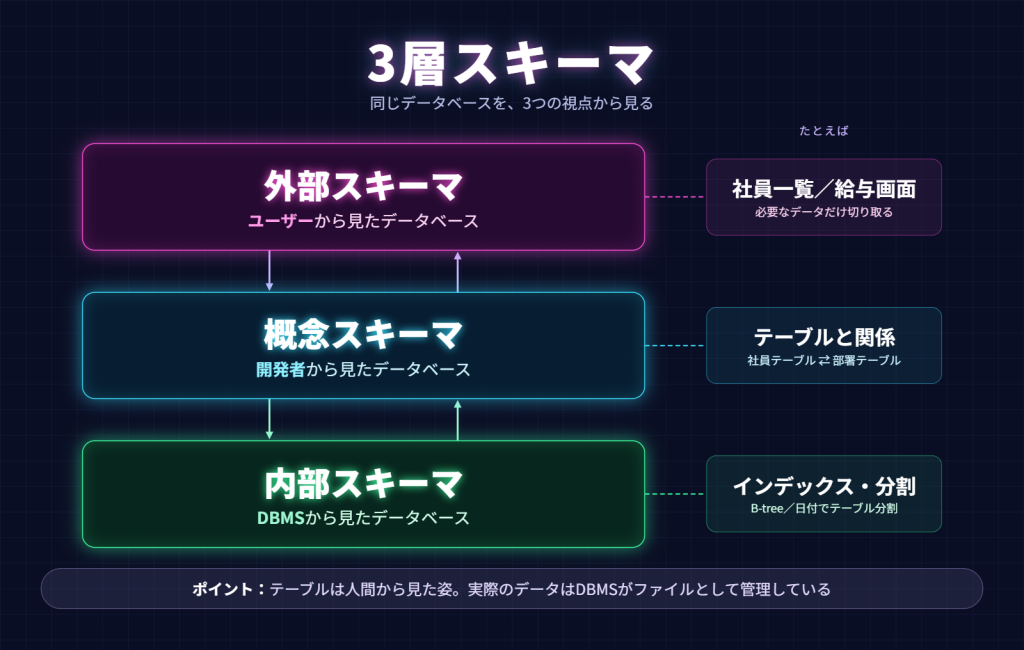
- 外部スキーマ — ユーザーから見たデータベース
ユーザーごとに、必要なデータだけを切り取って見せる層です。
たとえば、社員情報を扱うシステムなら、社員一覧画面では氏名や所属だけを表示し
別の画面では給与まで表示するといったように、同じデータを用途に応じて違う形で見せることができます。
見た目は違っても、裏側にあるデータはもちろん共通です。
同じデータを、見る人や用途によって違う形に切り取る。 この見せ方の定義が外部スキーマにあたります。
- 概念スキーマ — 開発者から見たデータベース
テーブルやテーブル同士の関係など、データベース全体の論理的な構造を定義します。
ユーザーがこのシステムのテーブル構造を直接見ることはできません。(できたら大問題!) - 内部スキーマ — DBMSから見たデータベース
DBMS内部で、データを実際にどうやって格納・管理するかという部分です。
私たちは普段「テーブルを作る」という感覚でいますが、DBMSはデータを内部的にファイルなどへ格納しています。
たとえばusersテーブルにレコードを1件INSERTすると、DBMSはそれを内部の記憶領域に書き込んでいます。
テーブルは、あくまで人間から見たときの姿なんですね!
具体的には、こんなことを決めるのがこの層です。
- インデックスをどこに、どう張るか — 検索を速くするために、どのカラムにどんな構造(B-treeなど)で作るか
- データをどう配置するか — 量が膨大になるテーブルを日付などで区切って分割するか、といった格納先の話
なぜ概念スキーマが必要なのか
ここまで読んでくださった方は、「え、内部スキーマが本体みたいなものなのに、なんで概念スキーマがいるの?」と思われたかもしれません。
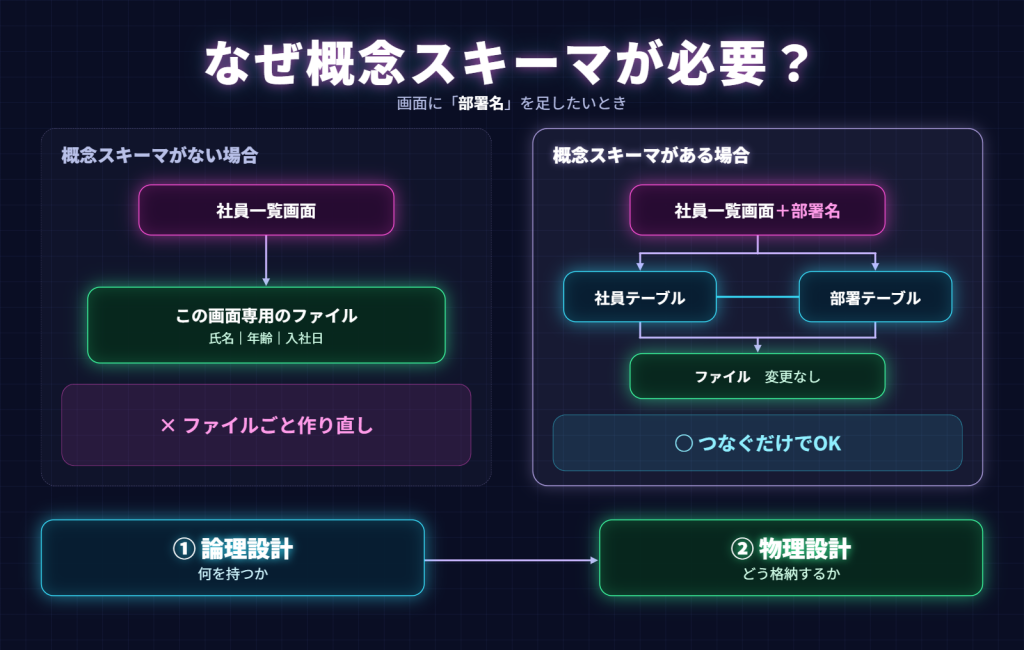
概念スキーマという層があることで、外部スキーマと内部スキーマをそれぞれ独立させ、変更による影響を抑えやすくすることができます。
たとえば、社員一覧の画面に「部署名」を表示したくなったとします。
概念スキーマがあれば、社員テーブルと部署テーブルがすでに定義されている場合、それらをつないで見せるだけで済みます。データの物理的な格納方法は何ひとつ変わりません。
ところが、外部スキーマと内部スキーマが直結しているような作りだと、画面に映る項目がそのままファイルの形になっています。「社員一覧画面用のファイル」に氏名・年齢・入社日が並んでいるような状態です。画面の見た目がそのままデータの形になっている、と考えると分かりやすいかもしれません。ここに部署名を足すには、ファイルの形そのものを作り直し、既存の全レコードを新しい形に移し替えることになります。
そこで緩衝材として概念スキーマを置き、外部スキーマと内部スキーマを独立させるわけです。
画面がどう変わろうと、格納方法がどう変わろうと、その影響をそれぞれの層の間で吸収しやすくなる。
だからお互いを気にせず変更しやすくなります。
この概念スキーマを設計することが「論理設計」、内部スキーマを設計することが「物理設計」です。
そして、何を持つかが決まらなければ、どう格納するかは決めようがないため論理設計 ⇒ 物理設計の順で行われます
あとがき
本当は正規化やインデックスの話もしたかったのですが、思ったより長文になってしまったのでまた次回以降にします!
最近はAIと一緒に設計や実装を進めることが当たり前になってきましたが、AIをうまく使いこなすためにも、結局は自分自身の基礎知識や理解が必要不可欠だなと日々痛感しています
AIのように日々進化するものについていくのももちろん大切ですが、それと同じくらい数年後でも変わらない基礎部分に目を向けることも大事だなと思いました。
それこそ、データをデータベースで管理するという根本の考え方はすぐには変わらないですし、
学んだ知識はずっと先まで生きてくると思いました。
最後まで読んでくださりありがとうございました(*'▽')


この記事をかいた人
About the author