我从阅读《数据库设计详解:向专家学习》一书中学到的东西
很高兴认识你!我是神田,系统开发部二年级员工(^^)/
这次,数据库设计终极指南:大师班(第二版的阅读感受
我为什么会拿起这本书?
在实际工作中,我们有时会在阅读规范的同时设计表格和 API。
每当这时,这个问题就会浮现在我的脑海中……
- “首先,我应该在表中存储哪些值?”
- “这一列应该包含在现有表格中,还是应该单独创建一个表格?”
- “除了用户 ID 之外,我还应该把索引放在哪里?”
在实际设计工作中,我们会参考现有表格、咨询人工智能以及在设计过程
中咨询资深同事来解决这类问题。
随着设计过程以这种方式继续进行,
“按照这些规格,表格结构大概会是这样的。”
“如果将这一列单独放在一个表中,使用起来会更方便。”
现在我大概能想象出一个好的身材是什么样子了。
就这样,随着经验的积累,我的设计能力也比以前更加娴熟。然而
有一天,我反思后意识到,我只是在照搬现有的表格结构,而
没有从根本上理解“为什么这种表格结构本身是好的”。
因此,我拿起这本书
,是因为我想学习什么是好的数据库设计,评判它的标准是什么,并且能够自信地、有坚实的基础地设计数据库!
读完之后,我觉得可以强烈推荐给一年级或二年级的工程师,他们可能会遇到和我类似的问题!
《数据库设计详解:向专家学习》第二版包含以下内容。
如果您认为其中可能包含您正在寻找的信息,请阅读一下!
【目录】
第一章:谁控制了数据库,谁就控制了系统
第二章:逻辑设计与物理设计
第三章:逻辑设计与规范化——为什么需要对表进行分区?
第四章:ER图——表示多个表之间的关系
第五章:逻辑设计与性能——规范化与反规范化的缺点
第六章:数据库与性能
第七章:逻辑设计中的反模式
第八章:逻辑设计中的灰色地带知识
第九章:高级逻辑设计——处理关系数据库中的树状结构 附录
(练习答案)
总体印象
- 这本书的文字简洁易懂,结构清晰,避免了阅读时的挫败感和枯燥感。书中
没有晦涩难懂的表达或句子,读起来非常流畅。
我个人比较容易被包含大量代码的书籍吓到,心想“这本书是不是离我太远了……”。然而,
这本书讲的是数据库,SQL语句很少,所以我读起来毫不费力。
简洁的要点,并提供了练习题。
正因如此,我才能如此轻松地读完这本书,没有感到任何挫败或厌倦! - 这本书旨在帮助你从不同的角度看待数据库设计,
它主要是一本“指南”,因此不会
深入探讨特定领域或提供具体的数据库设计步骤。
它涵盖的主题十分广泛,
从“什么是数据库?”
本书难度适中,既不太难也不太容易。
它还涵盖了实践中经常遇到的规范化和ER图,因此
有实践经验的人应该能够轻松理解相关概念。
另一方面,本书后半部分逐渐偏重理论。
第九章“高级逻辑设计——关系数据库中树状结构的处理”而不是那些寻求立即应用的人
似乎更适合那些想要深入了解数据库的人,
因此,我建议先阅读与你的工作直接相关的章节,然后在有更多时间的时候再阅读理论部分!
我学到的一些特别的东西
为什么我们要先设计数据库?
你有没有想过,“为什么我们要先设计数据库?”
我一直认为设计数据库是第一步,从未对此提出过质疑。
然而,读完这本书后,我了解到先设计数据再进行编程并不总是惯例,而且
曾经有过顺序颠倒的情况。
按“数据⇒程序”顺序进行设计的方法称为数据中心方法(DOA),而
按“程序⇒数据”顺序进行设计的方法称为流程中心方法(POA)。
我很好奇POA的受欢迎程度为何会从POA转向DOA,所以我做了一些研究。
POA 占据主导地位的时代
POA(行动点)是 20 世纪 60 年代和 70 年代系统开发的主要方法之一。
当时,例如“让我们用计算机来计算工资吧!”
出现了一种趋势,即用计算机取代以前由人类手动完成的任务
在这种情况下,第一步是准确识别人工执行的任务,
然后将这些任务直接转化为程序。
以工资计算为例,这些任务可能如下所示:
- 收集工时卡
- 统计工作天数和加班时长。
- 从员工名册中查明基本工资。
- 支付金额的计算方法是:加上加班费,减去税款和保险费。
接下来,我们将这些步骤直接转化为程序。
具体如何存储数据以及存储哪些数据,将在步骤最终确定后,根据程序的需求来决定。这种
先确定步骤再确定数据的方法,我们称之为面向过程的架构(POA)。
DOA变得重要的原因
然而,业务流程确实会发生变化。
例如,“员工基本工资”等数据既用于工资计算,也用于绩效评估。
然而,如果从流程中心的角度设计系统,最终会导致每个流程的数据都是分开的,例如工资计算数据和绩效评估数据。即使内容相同——“员工基本工资”——相同的信息最终也会分散在各处。
这意味着,当基本工资调整时,所有细节都必须一丝不苟地更新。
如果哪怕漏掉一个细节,不同屏幕上显示的金额都会不同。
正是在那时,《生死格斗》(Dead or Alive,简称DOA)开始受到重视。
尽管流程可以无限变化,但最终被处理的数据本身却不易改变(它是持久的),这与流程相比变化较小。基于这一点,面向数据对象(DOA)方法旨在预先定义数据的含义和格式。
如果您事先确定“员工信息包含员工编号、姓名、部门和基本工资”,那么在任何流程中,无论是工资计算还是绩效评估,您都只需要参考相同的数据。即使基本工资有所调整,您也只需要在一个地方进行更改。
此外,关系型数据库的广泛应用也发挥了重要作用。与过去数据存储在文件中不同,现在的数据可以集中管理,并可根据用户需要随时检索。以数据为中心的系统设计在技术上已成为可能。
这就是如今常见的“从数据库设计开始”的做法的由来。
那么,数据库设计究竟包含哪些决策呢?
它指的是只向每个用户显示必要数据的层。
例如,在一个处理员工信息的系统中,员工列表页面可能只显示姓名和部门,
而另一个页面可能还会显示薪资。相同的数据可以根据不同的用途以不同的方式呈现。
尽管外观可能不同,但底层数据当然是相同的。
相同的数据会根据查看者和用途的不同而以不同的方式呈现。定义这种呈现方式正是外部模式的作用所在。
要理解这一点,三层架构的概念
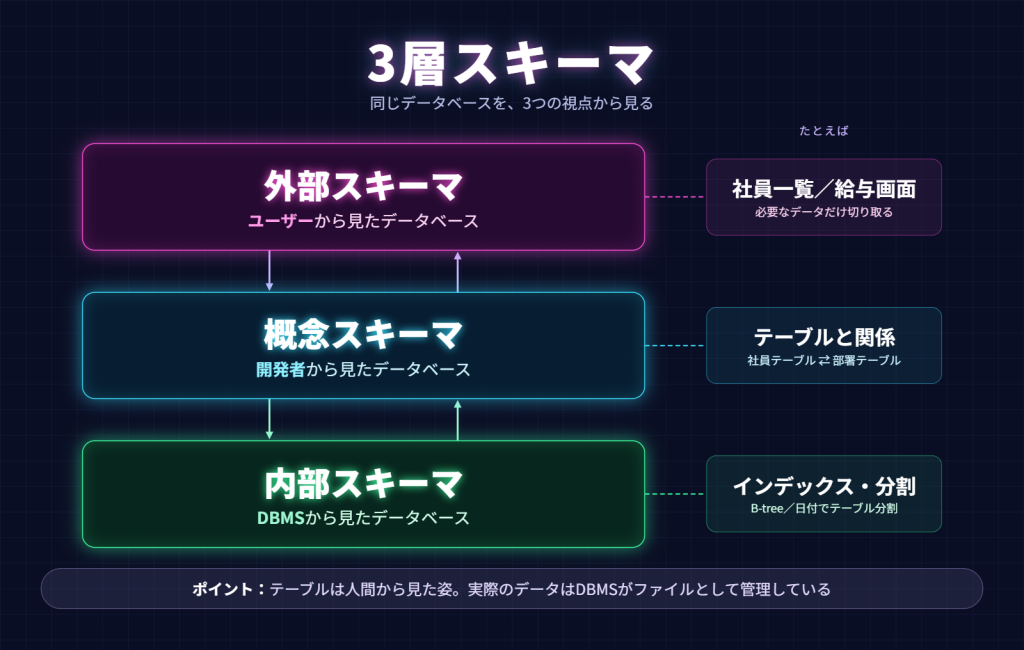
三层架构
- 外部模式——
这一层仅从数据库用户的角度向每个用户显示必要的数据。
例如,在一个处理员工信息的系统中,员工列表页面可能只显示姓名和部门,
而另一个页面可能还会显示薪资。相同的数据可以根据不同的用途以不同的方式显示。
当然,底层数据是相同的,尽管显示方式不同。
这种根据查看者和用途以不同方式显示相同数据的方法,正是外部模式的定义所在。
- 概念模式——从开发人员的角度定义了整个数据库的逻辑结构,包括数据库表以及表之间的关系
用户无法直接查看此系统的表结构。(如果可以,那将是一个大问题!) - 内部模式——
这是从数据库管理系统(DBMS)的角度来看的数据库部分,它定义了数据在DBMS内部的实际存储和管理方式。
我们通常将其理解为“创建表”,但实际上DBMS内部将数据存储在文件和其他存储介质中。
例如users表中插入一条记录时,DBMS会将其写入其内部存储区域。
表仅仅是从人的角度来看的样子!
具体来说,这一层决定了以下内容:
- 在哪里以及如何创建索引 ——使用哪些列以及以何种结构(例如 B 树)创建索引以加快搜索速度。
- 如何组织数据 ——这指的是存储位置,例如是否根据日期或其他标准将庞大的表格拆分成多个部分。
为什么需要概念框架?
读到这里,你可能会疑惑:“等等,如果内部模式是核心,为什么还需要概念模式呢?”
概念模式层的作用在于将外部模式和内部模式分离,从而更容易地将变更的影响降到最低。
假设你想在员工列表屏幕上显示“部门名称
如果你已经定义了概念模式,并且员工表和部门表也已经存在,那么你只需要将它们连接起来并显示信息即可。数据的物理存储方式完全不需要改变。
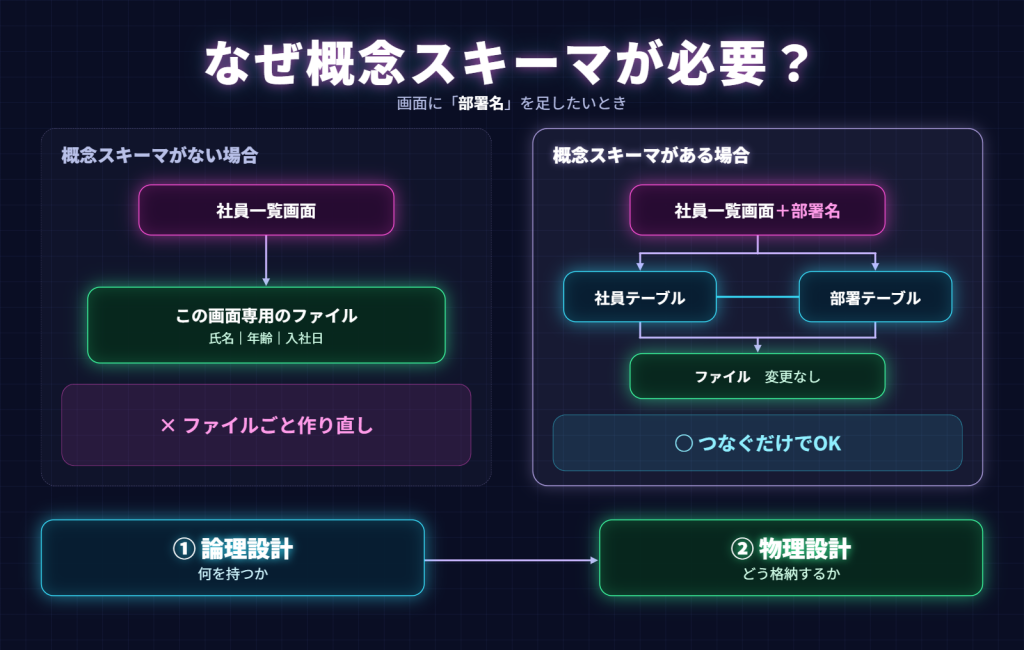
但是,如果外部模式和内部模式直接关联,屏幕上显示的内容将直接反映在文件中。例如,“员工列表屏幕文件”将包含姓名、年龄和入职日期。您可以将屏幕外观理解为数据形式的直接反映,这样可能更容易理解。要添加部门名称,您需要重新创建文件并将所有现有记录转换为新格式。
因此,概念模式被用作缓冲区,将外部模式与内部模式隔离开来。
无论屏幕如何变化或存储方式如何变化,其影响都能更容易地在各层之间相互吸收。
这使得在进行更改时更容易避免相互干扰。
设计这种概念模式称为“逻辑设计”,设计内部模式称为“物理设计”。
由于在确定存储内容之前不可能确定如何存储,因此该过程按逻辑设计→物理设计的顺序进行。
后记
我其实也想谈谈规范化和索引,但是这篇文章比我预想的要长,所以下次再谈吧!
如今,利用人工智能进行设计和实施已经司空见惯,但我始终记得,归根结底,要有效利用人工智能,扎实的知识和理解基础至关重要。
虽然了解像人工智能这样日新月异的事物固然重要,但我意识到,关注那些即使几年后也不会改变的基本方面同样重要。
正因如此,数据库中数据管理的基本理念在短期内不会改变,而且
我觉得我所学到的知识在未来很长一段时间内都会有用。
感谢您读到最后 (*'▽')


这篇文章的作者
关于作者